Yanıt özeti: Bir insanın görüntüden okuyup yazacağı kod, doğası gereği hatayı tespit edebilmelidir. 5 veri rakamı ve 1 Luhn kontrol rakamından oluşan 6 haneli kod, her tek basamak hatasını %100 yakalar ve komşu iki rakamın yer değiştirmesinin büyük bölümünü de; her mağaza başına 100.000 kod kapasitesine sahiptir ve müşterinin yazması için zahmetli olmayacak kadar kısadır.
Sorunu tam olarak tanımlayalım
Göndericisi görsel, alıcısı insan gözü ve iletim kanalı mobil klavye olan bir iletişim kanalımız var. Her kanal gibi bu da gürültüye sahiptir: rakam yanlış okunur, parmak bitişiğindeki rakama basar, iki rakam yer değiştirerek yazılır. Hata algılama literatüründe manuel rakam girişinde üç baskın hata türü bilinmektedir:
- Tek basamak hatası (single-digit error): Yanlış bir rakam — en sık karşılaşılan hata.
- Komşu yer değiştirme (adjacent transposition): «47» yerine «74».
- Çift ve atlama hatası: Rakamın tekrarlanması veya atlanması.
Kontrol hanesi olmadan, tek haneli her hata yüksek olasılıkla başka geçerli bir koda dönüşür. Bu, müşterinin hiçbir uyarı almadan yanlış ürün sayfasına girmesi anlamına gelir — olası en kötü durum, çünkü sistem güvenilir görünür ama yanlıştır.
Neden Verhoeff veya Damm değil de Luhn?
Üç klasik ondalık kontrol basamağı algoritması vardır:
| Algoritma | Tek haneli hata | Bitişik yer değiştirme | Uygulama karmaşıklığı |
|---|---|---|---|
| Luhn | ۱۰۰٪ | Çoğu durum (09/90 hariç) | Birkaç satır, tablosuz |
| Verhoeff | ۱۰۰٪ | ۱۰۰٪ | Üç 10×10 tablo (iki yönlü grup) |
| Damm | ۱۰۰٪ | ۱۰۰٪ | 10×10'luk bir yarı-grup tablosu |
Hata yakalama gücü açısından Verhoeff ve Damm algoritmaları üstündür. Ama bizim tercihimiz Luhn oldu ve nedeni matematik değil, mühendisliktir: ürün kodu sunucunun yanı sıra müşteri tarayıcısında da form gönderilmeden önce denetlenir; böylece hata, ağ gidiş-dönüşü olmadan anında görülür. Luhn, hiçbir tablo kullanmadan birkaç satır JavaScript ile uygulanır, sunucu tarafı ile tarayıcı tarafı uygulamalar arasındaki tutarsızlık riskini en aza indirir ve milyarlarca banka kartı numarasının doğrulanmasında kullanılan algoritmadır — yani gerçek dünyada test edilmişlik düzeyi rakipsizdir. Luhn'un kapsamadığı hata türü (09↔90 yer değiştirmesi), 5 haneli alanda hataların küçük bir payını oluşturur ve uygulama sadeliği karşılığında kabul edildi.
İddia değil, sayısal test
Tasarımı otomatik testle ölçtük: 200 rastgele kod üretildi ve her kodda 6 basamak konumunun her biri olası 9 farklı rakamla değiştirildi — yani 200×6×9 = 10.800 tek haneli mutasyon. 10.800 durumun tamamı geçersiz kod olarak tespit edildi. Bu, Luhn algoritmasının teorik garantisiyle aynıdır, ama «çalışması gerekir» ile «bizim kodumuzda çalışıyor» arasındaki farkı bu test ortaya koyar.
Neden 5 haneli veri? Kapasite hesabı ve tahmin
5 basamak 100.000 olası kod demektir. Binlerce ürünü olan bir mağaza için kullanılan alan toplamın küçük bir kesimidir; kodlar rastgele atandığından (sıralı değil) mevcut koddan sonraki ürün kodu tahmin edilemez. Bu önemli bir güvenlik noktasıdır: sıralı kod, ürün listenizi ve hatta katalog büyüme hızınızı rakibe ele verir.
Bununla birlikte açık olmak gerekir: bu kod bir tanımlayıcıdır, bir sır değil. Kod yalnızca ürünün genel sayfasına ulaşır; arkasında herhangi bir hassas işlem yoktur. Kodun özel bir kayda bağlandığı durumlarda (örneğin yarım kalan sepete geri dönüş), yol ayrı bir token ile korunur, kodun kendisiyle değil.
İngilizce metinde hiç var olmayan bir sorun: Farsça rakamlar ve çift yönlü metin
Bir kodu Farsça başlık içine yerleştirdiğinizde ya da sağdan sola görsel üzerine yazdığınızda, yolda iki gerçek tuzak bulunmaktadır.
۱) Giriş rakamlarının normalleştirilmesi
Müşteri kodu Farsça klavyeyle (۰۱۲۳), Arapça klavyeyle (٠١٢٣) veya Latin klavyeyle (0123) yazabilir. Girişi ham olarak karşılaştırırsanız doğru kod bile reddedilir. Çözüm: her doğrulamadan önce tüm rakamlar Latin'e normalize edilmeli — hem tarayıcıda hem sunucuda, ortak bir işlevle.
PERSIAN = "۰۱۲۳۴۵۶۷۸۹"
ARABIC  = "٠١٢٣٤٥٦٧٨٩"

def normalize(raw):
    out = []
    for ch in raw:
        if ch in PERSIAN:
            out.append(str(PERSIAN.index(ch)))
        elif ch in ARABIC:
            out.append(str(ARABIC.index(ch)))
        elif ch.isdigit():
            out.append(ch)
    return "".join(out)
2) Sağdan sola metinde görüntüleme sırası
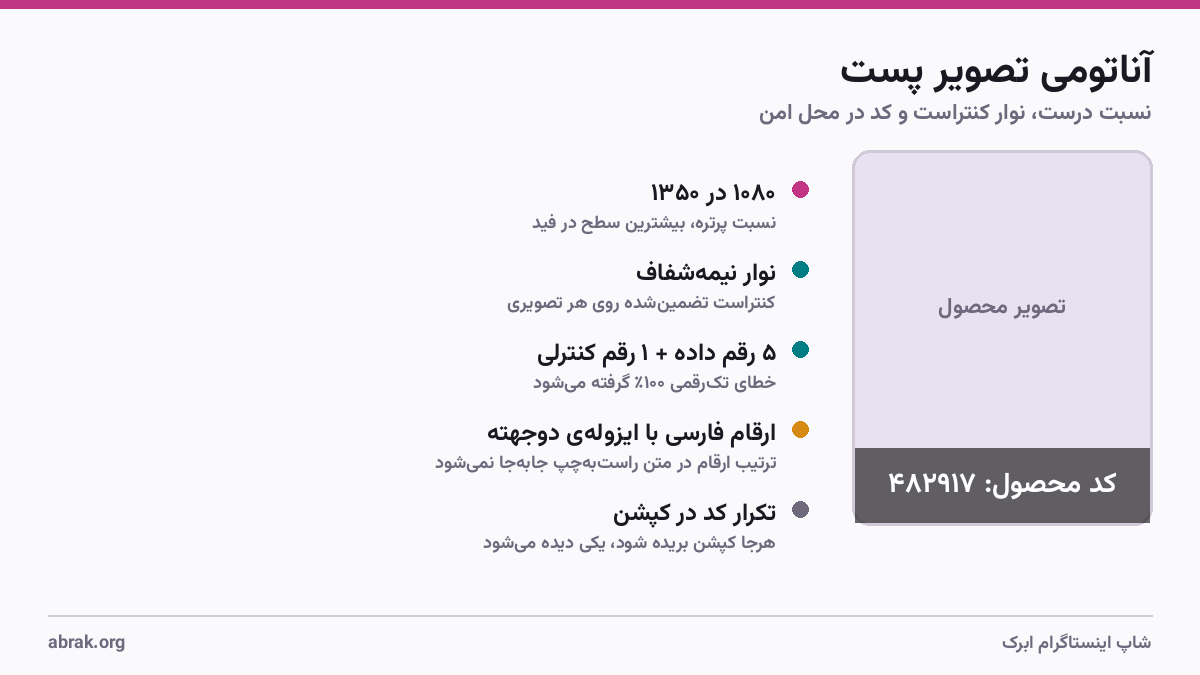
Unicode çift yönlü algoritması (UAX #9) sağdan sola metin içindeki rakamların nasıl yeniden sıralanacağını belirler. Pratik etkisi şudur: kodu okunabilirlik için gruplandırırsanız — örneğin "482 917" — Farsça metinde "917 482" şeklinde render edilebilir ve müşteri kodu ters okuyabilir. Bu hatayı teoride değil, gerçek bir görselde gördük.
İki karar bunu çözdü: rakam gruplandırması varsayılan olarak kapalıdır ve kod, çevresindeki hiçbir metnin düzenini değiştirememesi için her zaman çift yönlü izole ayırıcılar içinde (LRI ve PDI) basılır.
3) Görüntüye işlenirken harf biçimlendirmesi
Görsel üzerine Farsça metin yazmak için Pillow İki dünya mevcuttur: kütüphane desteğiyle Raqm oluşturulmuş olsun, karakter şekillendirmeyi kendisi HarfBuzz çift yönlü sıralamayı FriBidi ile yapar ve metni mantıksal biçimde (önceden yeniden sıralanmamış) vermeniz gerekir. Raqm yoksa şekillendirme ve yeniden sıralamayı kendiniz yapmanız gerekir. Yaygın hata — bizim de düştüğümüz hata — her ikisini birden yapmaktır: sonuç iki kez şekillendirilmiş ve harfleri karışmış bir metin olur. Doğru yol: çalışma zamanında Raqm'ın varlığını tespit edin ve yalnızca iki yoldan birini izleyin.
Kodu görselin neresine yerleştirmeliyiz?
Kodun okunabilirliği görsel tasarım sorunudur ve kod giriş oranını doğrudan etkiler. Önceden ayarlanmış birkaç pratik kural Abrak Instagram Mağazası Uygulanmıştır:
- Yarı Saydam Arka Plan Şeridi kodun altında; böylece her görselde kontrast güvence altına alınır.
- Alt köşe, kenardan uzak: Profil ızgara görünümünde ve tüm görsel oranlarında görünür kalan görüntü alanı.
- Görselin genişliğiyle orantılı yazı boyutu, sabit boyut değil — kod küçük besleme önizlemesinde de okunabilir olmalıdır.
- Altyazıda kodu tekrarlayın, tercihen son satırda: Altyazının nerede kesildiğine bağlı olarak iki tekrardan en az biri görünür.
Özet
6 haneli bir kod basit görünür, ancak içinde dört bağımsız karar gizlidir: uzunluk ve kapasite, hata algılama algoritması, Latin dışı rakamlar ve çift yönlü metin karşısındaki davranış ve görseldeki görsel tasarım. Bunlardan herhangi birindeki hata kendini «müşteri ürüne ulaşamadı» biçiminde gösterir — program hatası olarak değil. Bu kodun tüm satış yolundaki yerini görmek için, Instagram mağaza açığı makalesi ve bu kodu içeren gönderinin otomatik yayımlanması için, Otomatik yayın makalesi inceleyin.